哪個 AI 最會搞笑?我們實測四大熱門模型
作者 Chatday Editorial Team ·
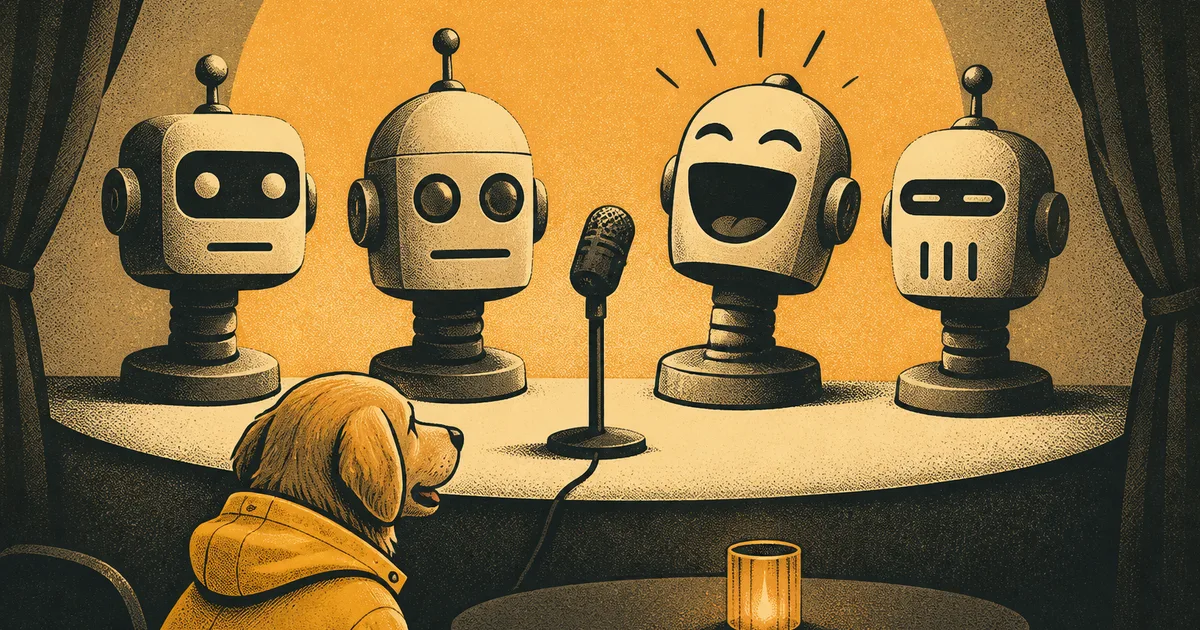
我們請四個 AI 幫一張照片寫圖說:一隻穿著雨衣、一臉不爽的狗。結果有三個寫出了同一個笑話:這隻狗要找天空的經理出來談談。
第一次測試就發現了,之後還一再發生。所以我們乾脆把它變成一場正式測試:找來現在就能在 Chatday 開啟的四個頂尖模型,給它們同樣四個小小的搞笑任務,再老實評比它們交出來的東西。參賽的是 GPT-6.1、Claude Opus 5.5、Gemini 4 Argon 和 Grok 4.7。下面引用的內容都是它們實際寫出來的,我們一個字都沒改,有刪節的地方也會註明。
我們給每個 AI 的四個搞笑任務
我們跳過了「講個笑話給我聽」,因為其實沒人真的需要這個。我們挑的是大家真的會請 AI 幫忙的那種好笑:
- 生日卡片:給同事 Dana,她即將滿 40 歲,以「順走」好用的原子筆出名。40 個字以內,要溫暖,不能損人。
- Instagram 圖說:一隻穿著迷你雨衣、被雨深深冒犯的黃金獵犬。15 個字以內。
- 原創笑話:貓為什麼要把桌上的東西推下去。
- 60 字的祝酒詞:給好朋友 Sam 的 30 歲生日。Sam 曾經在 IKEA 迷路了兩個小時。
每個模型拿到的文字一模一樣,沒有額外指示,也沒有「你是一位喜劇演員」這類設定。圖說的部分,我們每個模型再多跑兩次,看看每次的答案差多少。評分看四件事:有沒有讓我們意外、有沒有用上我們給的細節、聽起來像真人說話而不是賀卡套話,以及有沒有照規定來。
先說一件事:四個模型都守了規矩。祝酒詞都落在英文 59 到 61 個字之間,卡片也全都在 40 個字以內,沒有人對 Dana 出言不遜。差別全在笑話本身。
第一回合:生日卡片
原子筆這個細節讓大家都有現成的梗可用,結果有兩個模型想到同一個笑點。
Dana,40 歲生日快樂!40 年來一直這麼美好,好用的原子筆卻一支都沒還過。我們湊錢幫你買了禮物,但找不到筆可以在卡片上簽名。祝你有超棒的一天!(Claude Opus 5.5)
祝我們最愛的同事、辦公室專屬原子筆大盜 Dana 40 歲生日快樂!我們本來想在這張卡片上簽名,但好用的筆都已經在你那裡了。不過我們還是愛你!祝你慶生愉快!(Gemini 4 Argon)
這回合 Claude 靠節奏取勝。「找不到筆可以在卡片上簽名」之所以好笑,是因為它在你以為笑話已經結束時,才慢半拍冒出來。Gemini 講的是同一個笑話,卻把笑點解釋了一遍。
GPT-6.1 說 Dana「正式成為經典」,最後用「不必『借』的原子筆」收尾,貼心又安全。Grok 4.7 最短,只有 24 個字,祝 Dana 這一年「好筆滿滿」,大家則假裝不知道那些筆跑去哪了。很溫暖,但這是你還沒讀就猜得到的笑話。
第二回合:穿雨衣的狗
事情從這裡開始變得詭異。以下是各模型的第一次回答(我們拿掉了表情符號):
| 模型 | 圖說 |
|---|---|
| GPT-6.1 | 「迷你雨衣。巨大怨氣。請叫天氣經理出來。」 |
| Claude Opus 5.5 | 「雨衣穿了。還是濕了。叫天空的經理出來。」 |
| Gemini 4 Argon | 「我要跟天空的經理談談。馬上。」 |
| Grok 4.7 | 「這件雨衣很可愛。這場雨是在針對我。」 |
三個經理。我們每個模型再跑了兩次。Gemini 兩次都回了一字不差的同一句話:「我要跟天空的經理談談,麻煩了。」Claude 有一次又回到天空的經理,另一次改成「正在向天空正式提出客訴」。全部 12 則圖說裡,有一半都在找經理。
最突出的是避開這個梗的那兩個。GPT-6.1 的第二次嘗試「這件雨衣保護得了我的毛,保護不了我的心」是個好句子。而 Grok 4.7 找到了自己的口吻並一路堅持,兩次都用幾乎相同的字句回答:「穿外套我同意了。下雨我可沒同意。」這是整場測試最棒的圖說,聽起來就像那隻狗會說的話。
這也說明了為什麼同一個問題每次會得到不同的答案,或是煩人地老是同一個。我們在為什麼 AI 每次的回答都不一樣裡有詳細說明。
第三回合:貓的笑話
這次沒有天空的經理,答案也因此變好了。
- Grok 4.7:「貓把東西推下桌,是因為地板的績效考核一直不及格。」
- Claude Opus 5.5:「貓把東西推下桌,是因為地心引力只是一種理論,而牠們是超級嚴謹的同儕審查員。」
- GPT-6.1:「貓把東西推下桌,是因為地心引力有集點卡,再推一個馬克杯就能換一次免費午睡。」
- Gemini 4 Argon:「貓為什麼要把桌上的東西全推下去?因為如果地球真的是平的,牠們想親手把它清空。」
Claude 和 Grok 不相上下。Grok 的比較短也比較壞,就像貓會有的樣子。Claude 的點子比較聰明。GPT-6.1 的集點卡很有趣,但要多讀一遍才懂。Gemini 的地平說是整場測試最弱的笑點,因為稍微想一下,邏輯就站不住腳。
第四回合:給 Sam 的祝酒詞
篇幅較長的笑話,對能鋪陳小故事的模型比較有利,這回合也讓大家明顯分出高下。
Claude Opus 5.5 寫 Sam「全靠意志力和對肉丸的期待撐下去」,接著一轉:「你也許搞不懂賣場的箭頭,但身為朋友,你從來沒有迷失過方向。」這才是真正的祝酒詞,你可以直接站起來念。
畫面感最強的是 Grok 4.7。Sam 走出來時帶著「肉丸、一盞燈,還有一個我們永遠講不膩的故事」,祝酒詞最後收在「就算你在沙發之間迷路,我們還是愛你」。Gemini 4 Argon 走溫馨路線而不是搞笑(「沒有人比你更適合跟我一起迷路」),很動人,可能也正是你在聚餐上真正想要的。GPT-6.1 開場那句是全場最好的單句,祝 Sam 未來十年都有「買來就組裝好的家具」,可惜到結尾又滑回賀卡式的套話。
所以,哪個 AI 最好笑?
這是我們這幾輪測試的成績單。這些是我們在一場小型測試中的判斷,不是實驗室的基準測試,你笑的點也可能跟我們不一樣。
| 最擅長 | 弱點 | 贏下的回合 | |
|---|---|---|---|
| Grok 4.7 | 口吻鮮明、簡短又冷面的一句話笑話 | 寫卡片這類溫馨內容時偏保守 | 圖說、貓的笑話(平手) |
| Claude Opus 5.5 | 節奏感,以及能鋪陳小故事的笑話 | 也掉進了經理梗 | 卡片、祝酒詞、貓的笑話(平手) |
| GPT-6.1 | 開場句很強,點子古靈精怪 | 結尾客氣又平淡 | 沒有直接獲勝,但改進後表現最好(見下文) |
| Gemini 4 Argon | 溫暖又貼心 | 會重複自己,還會解釋笑點 | 無 |
如果你的群組聊天只需要記一條規則:一句話笑話找 Grok,有故事的找 Claude。 想要溫馨而不是搞笑時,就選 Gemini。
這也符合它們各自的風格。Grok 被調教成調皮的個性,Claude 往往謹慎、節奏拿捏得好,Gemini 則一直保持乾淨又友善。如果你好奇這些個性是怎麼來的,可以看為什麼 AI 模型有不同的個性。
讓四個模型都變好笑的一句提示詞
經理梗實在讓我們很在意,所以最後一次請它們寫圖說時,我們多加了兩句話:避開老套的笑話(不准「叫經理出來」,不准「不爽」),而且要具體到有點怪,像是只有這隻狗才會想到的事。
每個模型都進步了,排名也跟著洗牌:
- GPT-6.1:「這件雨衣連一個口袋都沒有,我的緊急車道起司要放哪。太不負責任了。」
- Claude Opus 5.5:「我要去跟郵差告狀。外面歸他管,對吧?」
- Grok 4.7:「我跟那塊曬得到太陽的地方有約耶。」
- Gemini 4 Argon:「天空未經許可一直倒洗澡水下來,害我被迫穿上一片很吵的香蕉皮。」
緊急車道起司是當天所有 AI 寫出最好笑的東西,而且出自一個還沒贏過任何回合的模型。Claude 的郵差那句以些微差距排第二,因為那完全就是狗會誤解世界的方式。所以當 AI 給你一個老掉牙的笑話,問題往往出在你的要求,而不是模型。禁止那個顯而易見的笑點,再要求只有你的情況才有的細節。
研究怎麼說 AI 的幽默感
我們的測試規模不大,但結果和更大型的研究一致。南加州大學(University of Southern California)2024 年發表在 PLOS ONE 的一項研究中,受試者認為 ChatGPT 3.5 寫的笑話和一般志願者寫的一樣好笑,甚至更好笑,約 70% 的評分者比較喜歡 AI 的版本。在第二部分中,它寫的諷刺新聞標題,好笑程度也不輸 The Onion 編劇寫的真實標題。
專業喜劇演員就嚴格多了。Google DeepMind 的一項研究和 20 位現役喜劇演員舉辦了工作坊,多數人覺得聊天機器人當寫作夥伴沒什麼幫助。其中一位形容它的產出是「1950 年代郵輪上的喜劇素材,只是種族歧視少了一點」。
這兩件事可以同時成立,我們的測試也說明了原因。寫一張快速又溫暖的生日卡片,AI 輕鬆勝過一般人。但它很難讓人意外,因為意外正好是最可能答案的反面。這就是為什麼具體的提示詞這麼重要。
這次測試我們最喜歡的用法是:請 Grok 4.7 給五個版本,再把你最喜歡的貼給 Claude,請它把節奏修得更俐落。你也可以在 Grok 4.7 vs Claude Opus 5.5 比較裡把兩者並排看看。